MySQL表分区(2)
分区数据维护和查询分区数据时,sql执行流程分析
一、目标问题
问题一:在执行删除分区数据操作时,相应的索引数据是否需要手动删除?
答 :分区适用于一个表的所有数据和索引;不能只对数据分区而不对索引分区,反之亦然,同时也不能只对表的一部分进行分区。对于同一个分区的数据和索引是一起维护在同一个idb文件中的,当删除了一个分区,也同时删除了该分区中所有的数据。
问题二:在执行跨分区查询时,是否需要指定相应的分区查询,以免扫描全表?
答:不需要,MySQL的查询优化器已经自动帮我们做了执行分区的处理,不过要注意在使用to_days()或者years()等函数指定分区字段时,由于存在出入非法的参数导出这两个函数的运算结果为null的可能,所以当跨分区查询时,除了查询条件对应的分区之外,还会指定第一个分区(默认null值存储在第一个分区中)。解决方案的话,在MySQL5.5版本之后,使用COLUMNS关键字进行分区即可。
二、分区的方案(初步)
- 使用pointDt字段按月去建立索引,每一个月的数据为一个分区,根据存储的数据为哪个月的,命名分区名称为p1-12;
- 再删除分区时,同时创建新的分区,维持分区数量在12个。
三、分区的策略
- 不使用索引
- 概述:创建数据表时不增加索引,而是使用分区定位到所需要的数据行。只要你使用 WHERE 条件将查询切分到很小的分区范围,就已经足够了。这个时候需要通过数学方法计算查询的响应时间是否能够接受。当然,这里的假设是不会将数据放到内存中,而是全部数据都从磁盘读取。因此数据很快就会被其他查询覆盖,使用缓存没什么意义。这种情况一般用于大量数据表的基数是常规的。需要注意的是,需要限制分区数在几百。
- 使用索引,并且隔离热区数据
- 概述:如果除了热区数据外,大部分数据是不使用的,则可以将热区数据单独的分区,这个分区算上索引都能够加载到内存中。这个时候可以通过索引来优化性能,就像操作普通的数据表一样。
- 使用部分主键作为分区字段,同时将分区字段建索引:使用组合主键(imei,pointDt)中的pointDt作为分区字段,同时维护一个pointDt字段的普通索引。
- 建表速度:
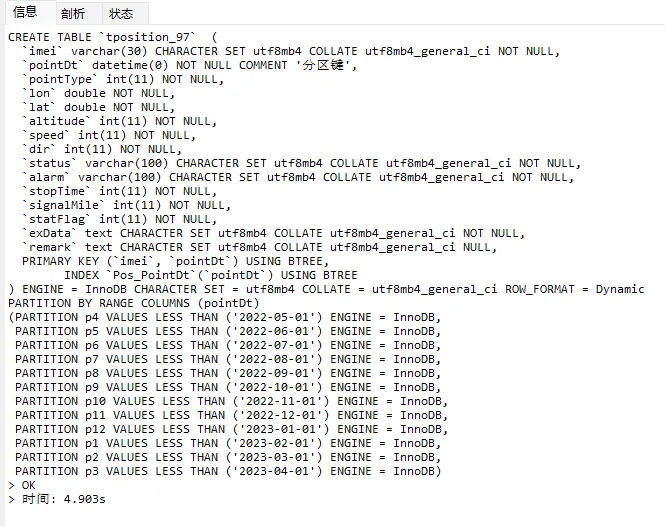
- 执行计划分析-带imei查询
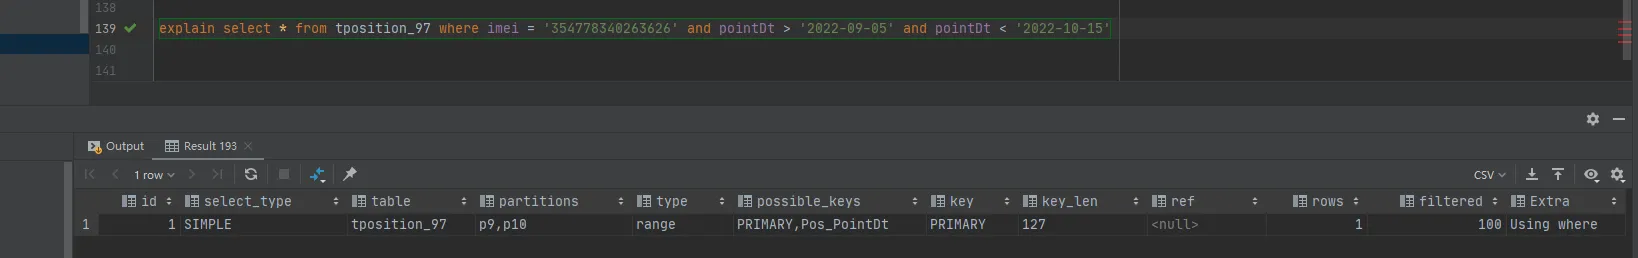
- 命中分区:p9,p10
- 检索类型:range,按照指定范围检索
- 实际使用的索引为主键
- key_len:127 = 30 * 4 + 2 + 5
- 30为imei字段的建表时指定长度,即varchar(30)
- 4表示表指定字符集为utf8mb4
- 2表示imei字段为不定长
- 5表示pointDt字段为非空的datetime类型
- rows的值为1,由于是空表,不具有参考性
- extra:Usig where
- 执行计划分析-不带imei查询
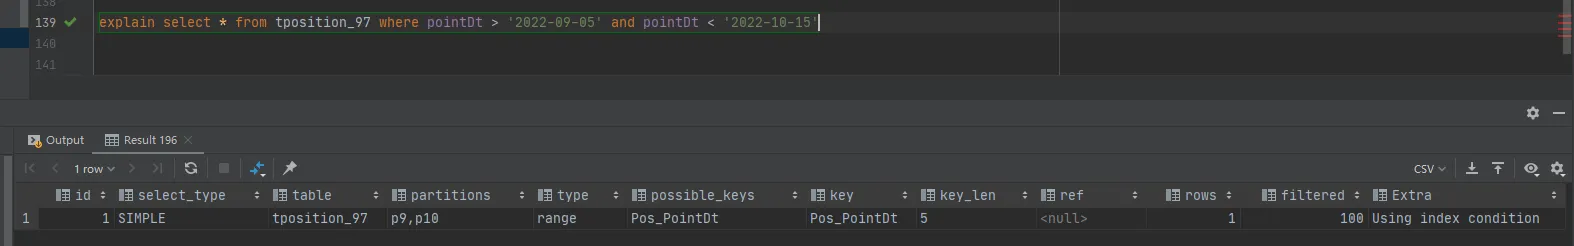
- 命中分区:p9,p10
- 检索类型:range,按照指定范围检索
- 实际使用的索引为Pos_PointDt
- key_len:5
- extra:Using index conditino
- 建表速度:
- 使用部分主键作为分区字段:使用组合主键(imei,pointDt)中的pointDt作为分区字段,不另外维护索引。
- 建表速度:
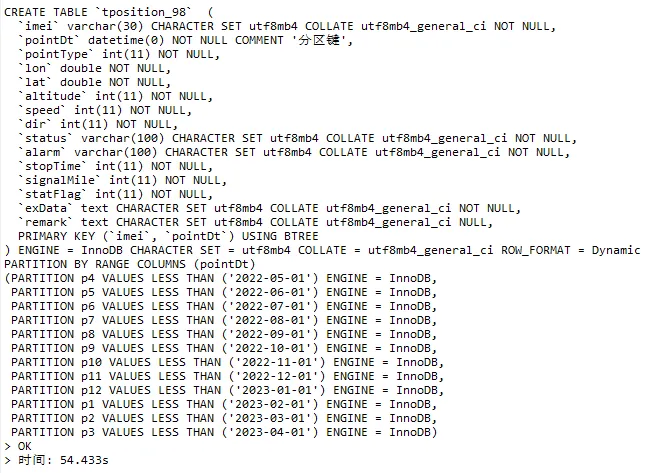
- 执行计划分析-带imei:与b基本一致
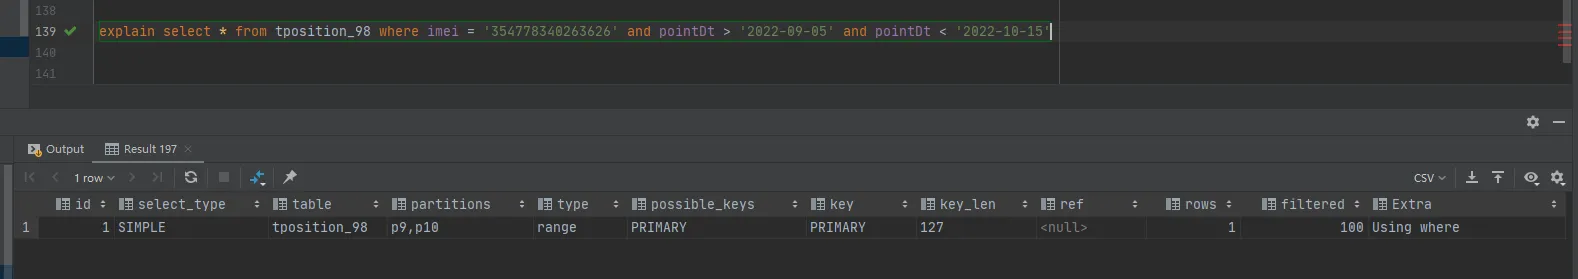
- 执行计划分析-不带imei
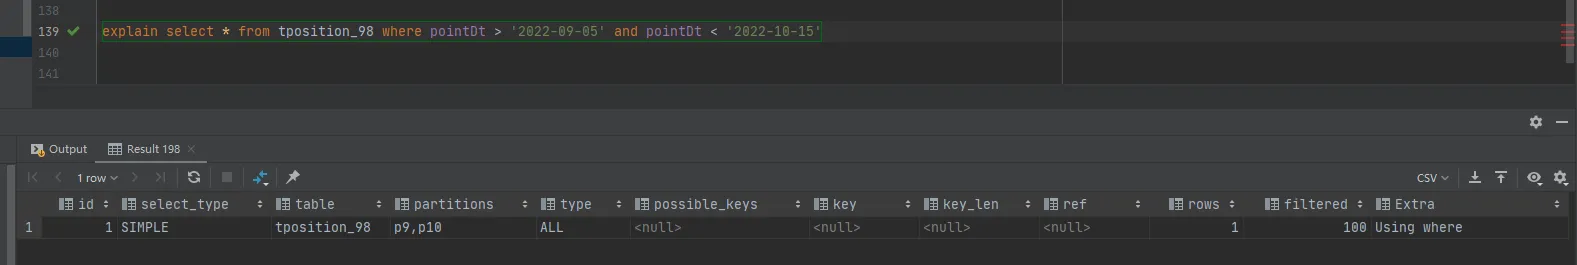
- 命中分区:p9,p10
- 检索类型:all,全表扫描
- extra:Using where
- 建表速度:
- 说明
- MySQL的分区字段,必须包含在主键字段内:
- 因为每一个表都需要有主键这样可以减少很多锁的问题,由于上面讲过主键需要解决全局唯一性并且在插入和更新时可以不需要去扫描全部分区,造成主键和分区列必须存在关系;所以最好的分区效果是使用主键作为分区字段其次是使用部分主键作为分区字段且创建分区字段的索引,其它分区方式都建议不采取。
四、分区的注意事项
1. NULL位会使分区过滤无效
- 关于分区表一个容易让人误解的地方就是分区的表达式的值可以是NULL:第一个分区是一个特殊分区。假设按照PARTITION BY RANGE YEAR(order_date)分区,那么所有order_date为NULL或者是一个非法值的时候,记录都会被存放到第一个分区。现在假设有下面的查询:WHERE order_date BETWEEN ’2012-01-01’AND’2012-01-31’。实际上,MySQL会检查两个分区,而不是之前猜想的 一个:它会检查2012年这个分区,同时它还会检查这个表的第一个分区。检查第一个分区是因为YEAR()函数在接收非法值的时候可能会返回NULL值,那么这个范围的值可能会返回NULL而被存放到第一个分区了。这一点对于其他很多函数,例如TO_DAYS()也一样。
- 如果第一个分区非常大,特别是当使用“全量扫描数据,不要任何索引”的策略时,代价会非常大。而且扫描两个分区来查找列 也不是我们使用分区表的初衷。为了避免这种情况,可以创建一个“无用”的第一个分区,例如,上面的例子中可以使用PARTITION p_nulls VALUES LESS THAN(0)来创建第一个分区。如果插入表中的数据都是有效的,那么第一个分区就是空的,这样即使需要检测第一个分区,代价也会非常小。
- 在MySQL5.5中就不需要这个优化技巧了,因为可以直接使用列本身而不是基于列的函数进行分区:PARTITION BY RANGE COLUMNS(order_date).所以这个案例最好的解决方越是能够直接使用MySQL5.5的这个语法。
2. 分区列和索引列不匹配
- 如果定义的索引列和分区列不匹配,会导致查询无法进行分区过滤。假设在列a上定义了索引,而在列b上进行分区。因为每个分区 都有其独立的索引,所以扫描列b上的索引就需要扫描每一个分区内对应的索引。如果每个分区内对应索引的非叶子节点都在内存 中,那么扫描的速度还可以接受,但如果能跳过某些分区索引当然会更好。要避免这个问题,应该避免建立和分区列不匹配的索引,除非查询中还同时包含了可以过滤分区的条件。
- 听起来避免这个问题很简单,不过有时候也会遇到一些意想不到的问题。例如,在一个关联查询中,分区表在关联顺序中是第二个表,井且关联使用的索引和分区条件并不匹配。那么关联时针对第一个表符合条件的每一行,都需要访问并搜索第二个表的所有分区。
五、分区方案汇总
1. 建表语句
CREATE TABLE `tposition_0  (
  `imei` varchar(30) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `pointDt` datetime(0) NOT NULL COMMENT '分区键',
  `pointType` int(11) NOT NULL,
  `lon` double NOT NULL,
  `lat` double NOT NULL,
  `altitude` int(11) NOT NULL,
  `speed` int(11) NOT NULL,
  `dir` int(11) NOT NULL,
  `status` varchar(100) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `alarm` varchar(100) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `stopTime` int(11) NOT NULL,
  `signalMile` int(11) NOT NULL,
  `statFlag` int(11) NOT NULL,
  `exData` text CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `remark` text CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NULL,
  PRIMARY KEY (`imei`, `pointDt`) USING BTREE,
  INDEX `Pos_PointDt`(`pointDt`) USING BTREE
) ENGINE = InnoDB CHARACTER SET = utf8mb4 COLLATE = utf8mb4_general_ci ROW_FORMAT = Dynamic
PARTITION BY RANGE COLUMNS (pointDt)
(PARTITION p4 VALUES LESS THAN ('2022-05-01') ENGINE = InnoDB,
 PARTITION p5 VALUES LESS THAN ('2022-06-01') ENGINE = InnoDB,
 PARTITION p6 VALUES LESS THAN ('2022-07-01') ENGINE = InnoDB,
 PARTITION p7 VALUES LESS THAN ('2022-08-01') ENGINE = InnoDB,
 PARTITION p8 VALUES LESS THAN ('2022-09-01') ENGINE = InnoDB,
 PARTITION p9 VALUES LESS THAN ('2022-10-01') ENGINE = InnoDB,
 PARTITION p10 VALUES LESS THAN ('2022-11-01') ENGINE = InnoDB,
 PARTITION p11 VALUES LESS THAN ('2022-12-01') ENGINE = InnoDB,
 PARTITION p12 VALUES LESS THAN ('2023-01-01') ENGINE = InnoDB,
 PARTITION p1 VALUES LESS THAN ('2023-02-01') ENGINE = InnoDB,
 PARTITION p2 VALUES LESS THAN ('2023-03-01') ENGINE = InnoDB,
 PARTITION p3 VALUES LESS THAN ('2023-04-01') ENGINE = InnoDB);
2. 分区维护
- 增加分区
mysql> alter table tposition_0 add partition(
    -> PARTITION p4 VALUES LESS THAN ('2023-05-01')
    -> );
Query OK, 0 rows affected (0.06 sec)
Records: 0 Duplicates: 0 Warnings: 0- 删除分区
mysql> alter table tr drop partition p4;
Query OK, 0 rows affected (0.06 sec)
Records: 0 Duplicates: 0 Warnings: 0- 拆分分区
mysql> alter table tr reorganize partition p5 into(
    ->   partition s0 values less than('2023-05-15'),
    ->   partition s1 values less than('2023-06-01')
    -> );
Query OK, 0 rows affected (0.26 sec)
Records: 0 Duplicates: 0 Warnings: 0- 查看分区
select * from information_schema.PARTITIONS
where TABLE_NAME = 'tposition_63' and TABLE_SCHEMA = 'new_ljdw_pos_2'
六、参考